标签:bs4 sel new text bsp 准备 ext 一个 get
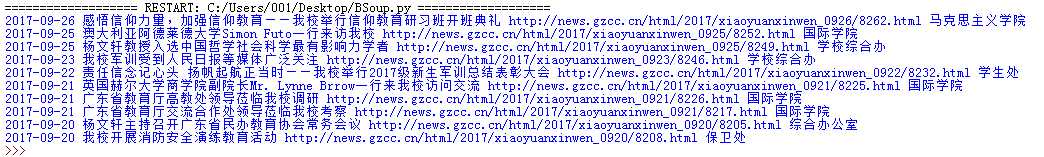
1.用requests库和BeautifulSoup4库,爬取校园新闻列表的时间、标题、链接、来源
import requests
from bs4 import BeautifulSoup

mt="http://news.gzcc.cn/html/xiaoyuanxinwen/"
res=requests.get(mt)
res.encoding=‘utf-8‘
soup=BeautifulSoup(res.text,"html.parser")

for news in soup.select(‘li‘):
    if len(news.select(‘.news-list-title‘))>0:
        title=(news.select(‘.news-list-title‘)[0].text)
        url=news.select(‘a‘)[0][‘href‘]
        day=(news.select(‘.news-list-info‘)[0].contents[0].text)
        sorce=(news.select(‘.news-list-info‘)[0].contents[1].text)
        print(day,title,url,sorce
2.选一个自己感兴趣的主题,做类似的操作,为“爬取网络数据并进行文本分析”做准备。
import requests
from bs4 import BeautifulSoup

mt="http://www.freebuf.com"
res=requests.get(mt)
res.encoding=‘utf-8‘
soup=BeautifulSoup(res.text,"html.parser")

for news in soup.select(‘li‘):
    if len(news.select(‘.title‘))>0:
        titles=(news.select(‘.title‘))

        print(titles)
用requests库和BeautifulSoup4库爬取新闻列表
标签:bs4 sel new text bsp 准备 ext 一个 get
原文地址:http://www.cnblogs.com/seed-ge/p/7608689.html
